− 본 아티클은 멀티코어 차량용 제어기 환경에서 소프트웨어 타이밍 안정성과 메모리 효율을 극대화하기 위해 개발된 AUTOSAR CP 기반 SW 분석 및 수리 제약 최적화 프레임워크의 개발 성과를 다룹니다.
− 특정 완성차 고객사의 프로젝트 식별 정보, 세부 제어기 사양 및 비공개 절대 성능 수치는 대외 보안 규정을 준수하여 일절 포함하지 않았으며, 공학적 방법론과 아키텍처 중심으로 기술되었습니다.
[Engineer’s Note]
차량용 제어기가 단일 칩 안에 여러 개의 두뇌를 갖춘 ‘멀티코어(Multi-core)’로 진화하면서, 임베디드 개발 현장에는 새로운 난제가 찾아왔습니다.
“기능 테스트는 분명 100% 통과했는데, 왜 실제 차에 올리면 타이밍이 어긋나고 메모리가 부족해질까?”
소프트웨어가 복잡해질수록 눈에 보이지 않는 ‘타이밍(Timing)’과 ‘메모리(Memory)’의 변동이 커지기 때문인데요, 그동안 현업에서는 이런 문제가 터질 때마다 수만 줄의 설정 파일을 밤낮으로 들여다보며, 개발자의 경험과 직관에 의존해 설정을 수동으로 손보는 사후 대응에 머물러 있었습니다.
하지만 $10^{45}$ 에 달하는 방대한 설정 조합을 언제까지 직관에만 맡길 수는 없는 노릇! 데이터 확보가 어려운 AI 대신, 실제 타깃에서 측정한 ‘하드웨어 실측 데이터’와 ‘수학적 제약 최적화(CP-SAT)’를 결합하는 현실적인 해법을 찾았습니다. 그 결과, 어플리케이션 코드 한 줄 손대지 않고도 가장 위험한 타이밍 병목을 제거하고 숨어 있던 메모리 여유까지 완벽히 확보했습니다.
경험에 의존했던 수동 튜닝을 ‘계산과 검증이 가능한 엔지니어링’으로 바꾼 HL클레무브 엔지니어들의 생생한 개발 여정을 공유합니다.
[Executive Summary] 세 가지 핵심 성과
1. 사후 튜닝에서 ‘사전 자동 최적화’로 패러다임 전환
문제가 발생한 후 개별 코드를 점검하던 수동 대응 탈피
▶ 구조 자동 분석 → 타깃 실측 모델링 → 수리 최적화 → 하드웨어 재검증 자동 파이프라인
2. $10^{45}$가지 설정 조합을 돌파한 CP-SAT 제약 최적화
사람이 계산할 수 없는 방대한 RTE/OS 파라미터 공간을 Google OR-Tools 솔버로 탐색
▶ 전체 경로 중 가장 취약한 ‘취약 조건’의 타이밍 마진을 수학적으로 극대화
3. 코드 수정 제로 : 타이밍 안정성 및 메모리 여유 확보
어플리케이션 로직 변경 없이 순수 Configuration(RTE/OS) 최적화만으로 실측 입증
▶ 코어 간 데이터 전달 변동 제거, COM 주기 지연 단축, 런타임 스택 메모리 최적화 달성
1. 프롤로그 : 기능 테스트는 통과했는데, 왜 타이밍이 흔들릴까?
차량용 임베디드 소프트웨어의 완성도는 단순히 “계산 결과가 맞다(기능 정상 동작)”는 사실만으로 입증되지 않습니다. 정해진 제어 주기를 단 1밀리초(ms)라도 어기지 않고 제때 데이터를 전달하는 ‘실시간성(Real-time Timing)’과, 칩의 한정된 물리적 공간을 안정적으로 유지하는 ‘메모리 한계(Memory Constraint)’를 동시에 충족해야만 양산 신뢰성을 얻을 수 있습니다.
현대 차량용 제어 소프트웨어의 표준인 AUTOSAR CP(Classic Platform) 환경에서는, 개발자가 작성한 제어 알고리즘(Application)이 동일하더라도 이를 연결해 주는 소프트웨어 통신망인 RTE(Run-Time Environment)와 스케줄러인 OS(Operating System)의 설정값에 따라 실제 런타임 타이밍이 완전히 달라집니다.
- Task Core Allocation : 특정 태스크를 어느 코어에 배치할 것인가?
- OsTaskPriority : 여러 태스크가 동시에 실행을 요청할 때 어떤 작업에 우선권을 줄 것인가?
- RteActivationOffset : 주기 태스크들이 한 시점에 일제히 몰리지 않도록 실행 시작 시점을 얼마의 시차를 두고 분산시킬 것인가?
- Task Execution Order : 하나의 태스크 안에서 실행 단위(Runnable)들을 어떤 순서로 처리할 것인가?
- OsStackSize : 각 태스크가 동작할 때 사용할 메모리 공간(스택)을 얼마나 할당할 것인가?
[멀티코어 제어기 안에서 벌어지는 보이지 않는 타이밍 위험]
Core 0 : 데이터 생성자(Producer) --- 어긋난 실행 타이밍 -→ Core 1 : 데이터 소비자
- A주기 : Producer가 데이터를 막 만들었을 때 Consumer가 읽음 → 최신 데이터 획득(정상)
- B주기 : 미세한 지연으로 Producer 생성 직전에 Consumer가 읽음 → 이전 주기의 낡은 데이터 획득(지연)
특히 여러 개의 연산 코어가 메모리를 공유하는 멀티코어 환경에서는 기능적으로 아무런 에러가 없더라도 다음과 같은 잠재 위험이 상존합니다.
- 코어 간 데이터 전달 타이밍의 불안정 : 한 코어에서 계산한 센서 값을 다른 코어의 제어 로직이 가져다 쓸 때, 두 작업 사이의 시간적 여유(Timing Margin)가 좁으면 하드웨어의 미세한 편차에 따라 어떤 주기에서는 방금 만든 새 데이터를 읽고, 어떤 주기에서는 이전 주기의 옛날 데이터를 읽는 ‘데이터 에이지(Data Age, 데이터 생성 후 소비되기까지 걸리는 시간) 변동’이 발생합니다.
- 통신 스케줄링(COM) 지연 : 로직에서 제어 명령을 계산해 두었더라도, 외부 차량 통신망(CAN/CAN-FD)으로 전송하는 통신 태스크가 로직 계산 직전에 먼저 실행되어 버리면 데이터는 다음 주기까지 전송되지 못하고 불필요한 대기 시간(Cycle Delay)을 겪습니다.
- 스택 메모리 낭비 : 만일의 사태에 대비해 스택 메모리를 과도하게 크게 잡아두면 정작 다른 핵심 기능이 쓸 RAM 공간이 부족해지고, 반대로 너무 작게 잡으면 런타임 중 시스템 리셋이라는 치명적인 결함으로 이어집니다.
소프트웨어 규모가 거대해지면서 수천 개의 데이터 경로와 수많은 설정 파라미터가 거미줄처럼 얽히게 되었고, 이를 개발자가 눈으로 확인하며 수동으로 조율하는 방식은 한계에 부딪혔습니다.
2. 시행착오 : “처음엔 AI가 다 풀어줄 줄 알았습니다.”
과제 초기, 우리 연구진의 첫 아이디어는 매우 도전적이었습니다.
“최신 트랜스포머와 강화학습(Reinforcement Learning) AI에게 설정을 맡겨보면 어떨까?”
다양한 설정 조합을 생성하고, 이를 타깃에게 실행한 뒤 측정값을 피드백으로 주어 AI가 최적의 설정을 스스로 찾아내도록 학습시키는 그림을 그렸습니다.
💡 “임베디드 타깃의 현실 : 시뮬레이터와 실물 칩은 달랐다.”
가상 시뮬레이션 환경이라면 수백만 번의 시행착오를 단 몇 시간 만에 돌릴 수 있습니다. 하지만 차량용 임베디드 소프트웨어는 가상 환경의 수치만 믿고 끝낼 수 없습니다.
후보 설정 하나를 평가하려면 매번 ‘설정 변경 → C소스 빌드 → 칩 플래싱(Flash) → 보드 실행 → 계측 장비로 타이밍 측정 → 분석’이라는 실물 하드웨어 파이프라인을 거쳐야 했습니다.
딥러닝 모델이 의미 있는 판단을 내리려면 수만~수십만 개의 신뢰성 높은 정답 라벨(Ground Truth)이 필요한데, 후보 하나 평가하는 데 한 시간 이상이 걸리니 데이터 확보 비용이 감당할 수 없을 정도로 치솟았습니다.
게다가 하드웨어 특유의 미세한 측정 편차 때문에 ‘이게 설정을 잘 바꿔서 개선된 건지, 칩의 일시적 노이즈인지’ 모호했고, 학습을 위해 위험한 설정(타이밍 제약 위반)을 실제 ECU에 플래싱하는 경우 동작하지 않는 경우도 많았습니다.
‘우리가 쫓던 것은 AI라는 수단이었지, 문제 해결 그 자체가 아니었구나.’
결국 우리는 AI 만능론을 내려놓고 근본적인 질문부터 다시 던졌습니다.
‘학습 데이터에 목매는 블랙박스 AI 대신, 실제 타깃에서 계측한 물리적 신호로 타이밍 모델을 세우고 수학적 최적화로 정밀하게 풀어내면 어떨까?’
3. 전략적 피벗 : 실측 기반 타이밍 모델과 제약 수리 최적화의 결합
연구진은 시행착오를 교훈 삼아, 실제 타깃 실측(Target Measurement)과 수리 최적화(Constraint Optimization)를 유기적으로 결합하는 새로운 프레임워크로 방향을 전면 전환했습니다.
모든 무작위 후보를 하드웨어에서 일일이 실행해 보는 비효율을 멈추고, 하드웨어 계측은 ‘정밀한 타이밍 모델을 세우는 단계’와 ‘수학적으로 검증된 최종 후보를 실제 검증하는 단계’에만 집중적으로 배치했습니다.

[실측 기반 Embedded SW Timing∙Memory 최적화 5단계 파이프라인]
1. AUTOSAR 구조 자동 분석
소스코드, ARXML, RTE 코드에서 실행 태스크 및 데이터 의존성 자동 추출
2. 실측 기반 타이밍 모델링
실제 타깃에서 Task 실행 시점, 선점(Preemption), 지연 시간 정밀 계측
3. 타이밍 ∙ 메모리 자동 진단
코어 간 통신 마진 부족 구간 식별, 통신 주기 지연, 스택 낭비 진단
4. CP-SAT 수리 제약 최적화
Google OR-Tools를 활용해 $10^{45}$ 가지 설정 중 ‘최악 조건 마진 극대화’ 탐색
5. 타깃 재검증 및 리포트
최적 설정을 실물 제어기에 반영해 반복 계측, 성능 개선 및 무회귀 확인
4. 구조 분석과 실측 : 설정 파일과 실물 하드웨어의 간극을 메우다
최적화를 수행하기 위한 첫 단추는 소프트웨어 내부의 뼈대와 핏줄을 투명하게 들여다보는 것입니다.
연구진은 엔지니어가 수작업으로 문서를 뒤지는 대신, 프로젝트의 기본 산출물(ARXML, 어플리케이션 소스, RTE 생성 코드)을 교차 분석하여 다음 관계망을 단숨에 뽑아내는 자동화 분석 파이프라인을 구축했습니다.
Runnable(실행단위) → Task(태스크) → Core (연산코어) → Port/Connector(인터페이스) → Producer / Consumer(생성/소비)
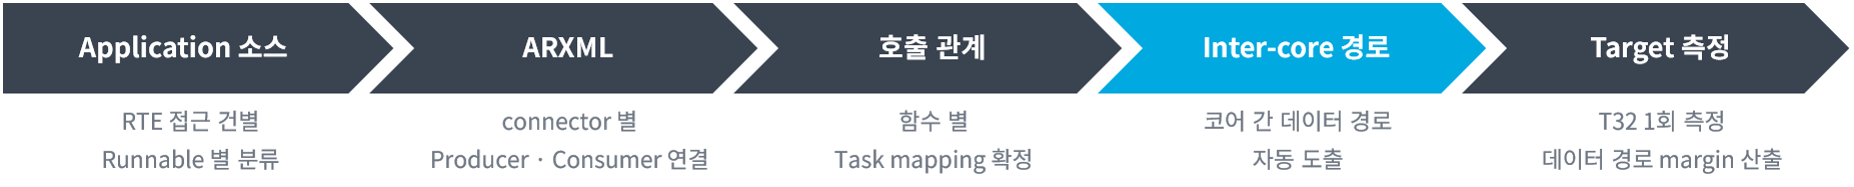
특히 서로 다른 코어에 배치되어 메모리를 주고받는 ‘코어 간 데이터 경로’를 자동으로 추적해 핵심 진단 대상으로 지정했습니다.
하지만 정적 코드 분석만으로는 실제 동작을 다 알 수 없습니다. 실제 칩 내부에서는 우선순위가 높은 다른 작업에 의한 가로채기인 선점(Preemption), 다른 비주기 작업의 개입인 인터럽트(Interrupt), 캐시 메모리 적중률 등 수많은 물리적 변수가 실시간으로 얽히기 때문입니다.
연구진은 하드웨어 트레이스 계측 장비를 통해 실제 타깃에서 태스크가 켜지는 시점(Activation), 데이터가 메모리에 쓰이는 순간(Generation), 다른 코어가 데이터를 읽어가는 시점(Read)을 정밀 계측했습니다. 정적 구조도 위에 실제 하드웨어의 맥박을 입혀 살아 숨 쉬는 ‘디지털 타이밍 모델’을 완성한 것입니다.
5. $10^{45}$ 가지 조합의 미로 풀기 : Google OR-Tools CP-SAT 최적화
최적화 대상이 되는 변수들은 서로 맞물려 돌아갑니다. 어느 한 태스크의 시작 시점(Offset)을 1밀리초 늦추면 앞선 태스크와의 충돌은 피할 수 있지만, 뒤따라오던 통신 태스크의 마진이 깨져버릴 수 있습니다. 이 파라미터들이 얽히고설키면 탐색해야 할 조합의 수는 $10^{45}$ 이상이라는 천문학적인 크기로 불어납니다.
연구진은 이 거대한 미로를 풀기 위해 구글의 제약 만족 최적화 엔진인 Google OR-Tools CP-SAT (Constraint Programming – Satisfiability) 솔버를 투입했습니다.
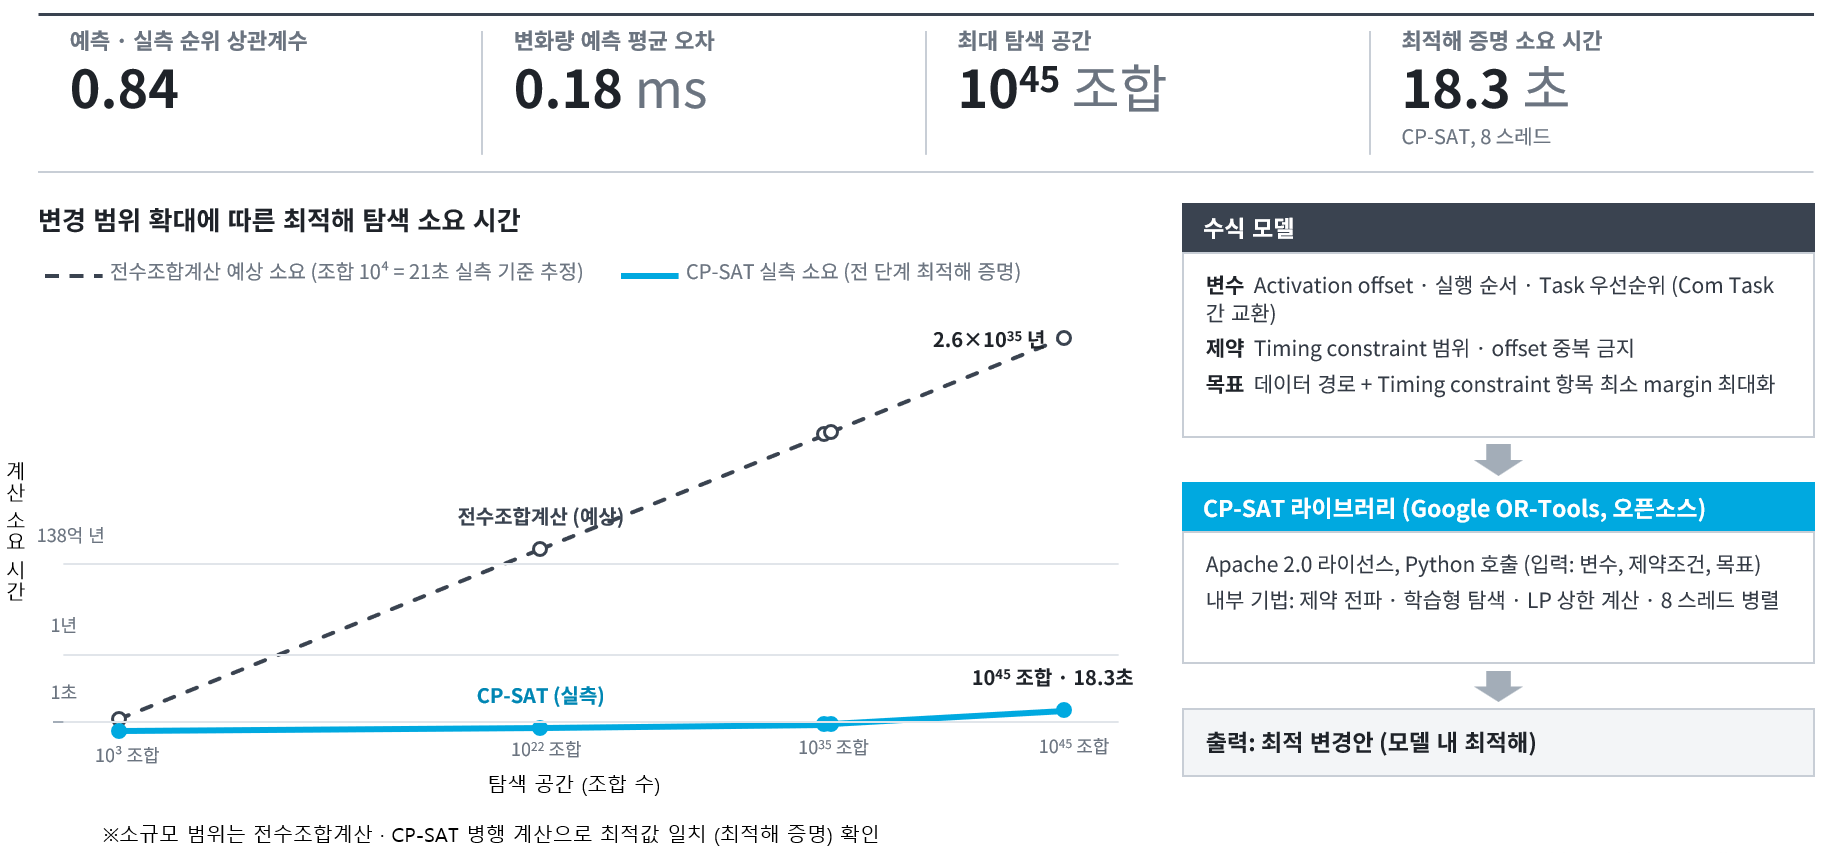
- 최적화 변수 : 각 태스크의 시작 지연 시차(RteActivationOffset), 실행 우선순위(OsTaskPriority), 실행 순서(Execution Order) 등
- 반드시 지켜야 할 제약 조건 :
- 기존 데이터 의존성과 제어 로직 순서를 훼손하지 않을 것
- 프로젝트가 규정한 마감 시간을 100% 만족할 것
- 설정 변경 허용 범위를 엄격히 준수할 것 - 최적화 목적 함수 (Objective) : “전체 데이터 경로 중 가장 취약한 최악 조건(Worst-case)의 타이밍 마진을 극대화하라!”
💡 왜 ‘평균’ 마진이 아니라 ‘최악 조건(Worst-case)’ 마진을 개선할까?
100개의 데이터 경로 중 99개의 마진이 아무리 넉넉해도, 단 1개의 경로가 아슬아슬하게 마진 부족 상태라면 그 시스템은 외부 부하가 튀었을 때 언제든 오동작을 일으킬 수 있는 시한폭탄입니다. 따라서 전체 평균치를 올리는 대신, 가장 위험하고 취약한 병목 구간의 마진을 최우선으로 끌어올리는 엄격한 안전 설계 원칙을 수학적으로 구현한 것입니다.
6. 통신 지연 단축과 런타임 스택 메모리 최적화
이 최적화 프레임워크는 타이밍뿐만 아니라 통신과 메모리 효율에서도 발군의 위력을 발휘했습니다.
1) 통신(COM) 주기 지연의 정상화
어플리케이션 로직이 최신 제어 명령을 계산해 두었더라도, 외부 차량 네트워크(CAN/CAN-FD)로 전송을 담당하는 통신 태스크가 로직 계산 직전에 먼저 실행되어 버리면 데이터는 다음 주기가 올 때까지 불필요한 대기 시간을 겪게 됩니다.
프레임워크는 로직 계산과 통신 샘플링 순서를 정밀하게 재배치하여, 로직 계산 직후 통신 태스크가 가장 신선한 최신 데이터를 낚아채 즉시 외부로 송출하도록 동기화했습니다.
2) 실측 기반 스택(Stack) 메모리의 군살 빼기
정적 설정 파일에는 만일의 사태에 대비해 스택 크기를 실제 사용량보다 몇 배씩 크게 잡아두는 경우가 허다합니다.
연구진은 타깃 계측 인터페이스를 통해 시스템이 가장 바쁘게 돌아갈 때의 ‘실제 최대 스택 사용량(Runtime Peak Usage)’을 측정했습니다. 이를 바탕으로 안전 마진을 충분히 확보하면서도 과도하게 부풀려 있던 태스크들의 스택 크기를 다이어트하여, 제어기 내부의 귀중한 RAM 여유 공간을 안전하게 되찾아왔습니다.
7. 현장 실측 검증 : 코드 한 줄 안 고치고 안정성을 증명하다
수학적 모델이 아무리 훌륭한 답을 내놓았더라도, 실제 자동차용 칩에서 재현되지 않으면 의미가 없습니다. 연구진은 솔버가 도출한 최적 설정값을 실제 소프트웨어 환경에 적용하고 칩을 구워 반복 측정 검증을 수행했습니다.
[최적화 프레임워크 적용 전후 비교]

| 적용 전 | 적용 후 | |
| 코어 간 데이터 전달 | [불안정] 주기별로 최신 데이터와 이전 데이터가 교차 수신됨 (Data Age 변동 발생) |
[안정] 충분한 마진 확보로 모든 주기에서 최신 데이터를 일정하게 안정 수신 |
| 통신 주기 지연 | [지연 발생] 로직 갱신 전 통신 태스크 실행으로 1주기 대기 발생 |
[즉시 송출] 로직 계산 직후 통신 태스크 실행으로 전송 대기 시간 최소화 |
| 메모리 자원 | [낭비/불안] 경험 기반 추정치로 과도한 낭비 또는 잠재적 마진 부족 공존 |
[최적 할당] 런타임 피크 실측치를 바탕으로 안전 마진을 둔 최적 메모리 확보 |
- 비즈니스 로직 수정 제로 : C 소스코드나 제어 알고리즘은 단 한 줄도 손대지 않고, 순수하게 AUTOSAR RTE/OS 설정 파라미터만 조정하여 성능을 개선했습니다.
- 무회귀성 검증 : 동일 조건에서의 반복 측정을 통해 단순 계측 노이즈가 아닌 실질적 개선임을 확인했으며, 주요 기능 Timing 항목에서 사이드 이펙트나 성능 저하가 발생하지 않음을 확인했습니다.
8. 에필로그 : 경험에 의존하던 튜닝에서 ‘계산 가능한 엔지니어링’으로
임베디드 소프트웨어 개발 현장에서 타이밍 이슈는 오랫동안 ‘문제가 터지면 밤새워 로그를 찍어보고, 경험 많은 시니어 엔지니어의 감에 의존해 오프셋을 조금씩 건드려보는’ 고통스러운 영역이었습니다.
이번에 구축된 최적화 프레임워크의 진정한 가치는, 이러한 사후 대응식 수동 튜닝을 소프트웨어 전체 구조를 미리 진단하고 수학적으로 해답을 찾아내는 ‘선제적 자동화 프로세스’로 바꿨다는 점에 있습니다.
HL클레무브는 본 기술을 특정 제어기 전용이 아닌 표준 AUTOSAR CP 기반 프로젝트 전반에 재사용할 수 있는 범용 파이프라인을 구축했습니다. 앞으로 코어 배치(Core Placement) 최적화와 가혹 런타임 부하 시나리오까지 프레임워크를 확장하고, 수식화가 까다로운 실행 시간 예측 영역에는 AI 기법을 선별적으로 융합하여, SDV의 두뇌를 가장 견고하게 지탱하는 엔지니어링 체계를 확립해 나갈 것입니다.


